
「帶長輩、吃素、少走路」,是台灣邁入超高齡社會下最真實的生活提問。寫到第 30 篇,LOCAL 留下的不只是一個會回答的 Agent,而是涵蓋 API、工具編排、LINE 應用到驗收的四個技術階層,以及能交給下一位工程師的程式、題庫與重現入口。今天回頭核對承諾,分開已執行成果與待接線工作,梳理 Google AI 選型取捨與反思,讓這套地方服務防護基礎能被接續採用。
LOCAL began with a grassroots question reflecting Taiwan's transition into a super-aged society: how can families comfortably take older relatives out when they prefer vegetarian meals and less walking? This final chapter reconciles series commitments, distinguishes historical measurements from unexecuted service cases, and reviews Google AI choices. A proposed sub-agent architecture outlines production expansion for elderly care and local governance. The handover preserves source versions, reproducible entry points and human responsibility rather than declaring every integration complete.
寫到第 30 篇,我又讀了一次 Day 1 的「帶長輩、吃素、少走路」,以及「會查、會做、會記,也會說不知道」。依內政部統計,台灣在 2025 年底 65 歲以上人口已達兩成。[8] 對準備出門的家人而言,重要的不是接了幾個模型,而是資訊有沒有依據、詢問有沒有保存。LOCAL 留下的核心選擇是:讓模型理解不整齊的需求,讓流程保留不能省略的責任。
今天現場的一句話:我把電腦闔上後,下一個人接得下去嗎?
後端決定的規則:確認、授權與原單狀態,各有可查的依據。
Google AI 的位置:理解與抽取交給模型,完成判定交回工具及後端。
三分鐘入口:第七節從固定版本執行離線評分器與規格檢查。
本日交付:承諾對帳、歷史度量、選型取捨及有驗收順序的交接藍圖。
LOCAL 的五個面向,現在可以各指向一份資產,而不只是五個字母。[1]
| 設計面向 | 累積的資產與代表篇 | 接手時先看什麼 |
|---|---|---|
| L|LINE-native Interface | Day 4 簽章驗證、Day 13 確認與舊卡、Day 17 降級呈現、Day 27 手機查回 | 畫面狀態與原單是否一致 |
| O|Orchestration & Tools | Day 5 活動查詢、Day 8 確認綁定、Day 9 建立詢問、Day 14 店家查詢 | 哪個動作需要本人確認 |
| C|Context & Consented Memory | Day 7 來源版本、Day 14 同意偏好、Day 15 上下文預算、Day 25 抽取 | 資料何時採用、何時撤回 |
| A|Assurance & Accountability | Day 16 最小權限、Day 18 20 題基準、Day 20 成本帳本、Day 24 實測、Day 29 100 筆規格 | 規格、觀測、判分各自的範圍 |
| L|Launch & Learning Loop | Day 10 離線 CI、Day 12 Cloud Run、Day 26 乾淨容器、Day 28 開源入口 | 固定版本與重現入口 |
我用四個技術階層整理這趟演進:API 階層問模型怎麼回;Agent 階層問工具怎麼選;應用階層問同意與單據怎麼保存;驗收階層問別人如何推翻我的判斷。最後一個階層,讓前三個都有能被檢查的完成條件。
「帶長輩」讓我把入口有坡道與全程能通行分開;「吃素」讓偏好保存必須經過本人同意;「少走路」讓沒有交通依據時的回答保留未知。地方需求不是套在範例外面的故事,而是決定欄位、狀態與驗收的條件。公車到站、停車餘位與照護派工,沒有因此變成已完成的功能。
我在奇步應用參與的縣府「愛玩彰化」系統,與奇步應用、白色方塊、旅庫彰化合作自營的彰化旅行+,各有自己的責任。爌肉之城帶來生活題材;既有營運經驗也提醒我,Day 17 區分的查無資料和當下查不了,對準備帶長輩出門的人是兩種不同麻煩。這些經驗供 LOCAL 設計參考,並非本系列新增使用人數。
| 原承諾與日次 | 現在可以交付 | 對帳結論 |
|---|---|---|
| Day 1 三項核心工具 | Day 5 活動查詢、Day 14 店家查詢、Day 9 受控建立詢問 | 查詢與寫入分工;真人受理另驗 |
| Day 1/Day 18 保留驗收集 | 未建立;local100 是公開修訂的開發規格 |
泛化成績未交付,不以開發題庫成績代替 |
| Day 18/Day 24 評測與比較 | 20 題基準、9 題模型路由、6 列 A/B;原規劃中期約 50 題的擴充未交付 | 各自保留分母及原始紀錄 |
| Day 25 第二資料來源 | 結構化抽取、審閱收據、SQLite 採用 | 5 筆模型案例、3 筆採用、2 筆阻擋;不是 3 家新店 |
| Day 26 乾淨重現 | Day 27 Cloud Shell 容器 155 項通過 | 外部邀請改為環境重現,未冒充真人試用 |
| Day 26 雙視窗接手 | 規格、Day 19 離線認領(demo-confirm)、Day 27 單手機查回 req-20261011-dcd85c8b18175111(b415a87) |
完整雙手機流程本系列內不補做,列為接手後第一項驗收 |
| Day 27 展示準備 | 三分鐘手冊與 SQLite 備援 | 錄影及線上模式按各自素材驗收 |
| Day 28 開源入口 | 中英文產品卡、Quickstart、MIT 與貢獻指南 | 文件與程式已交付;發布標籤另核對 |
| Day 29 總驗收基準 | 100 筆合成規格、42 項工具測試 | 本批服務觀測 0 筆,通過率為 null |
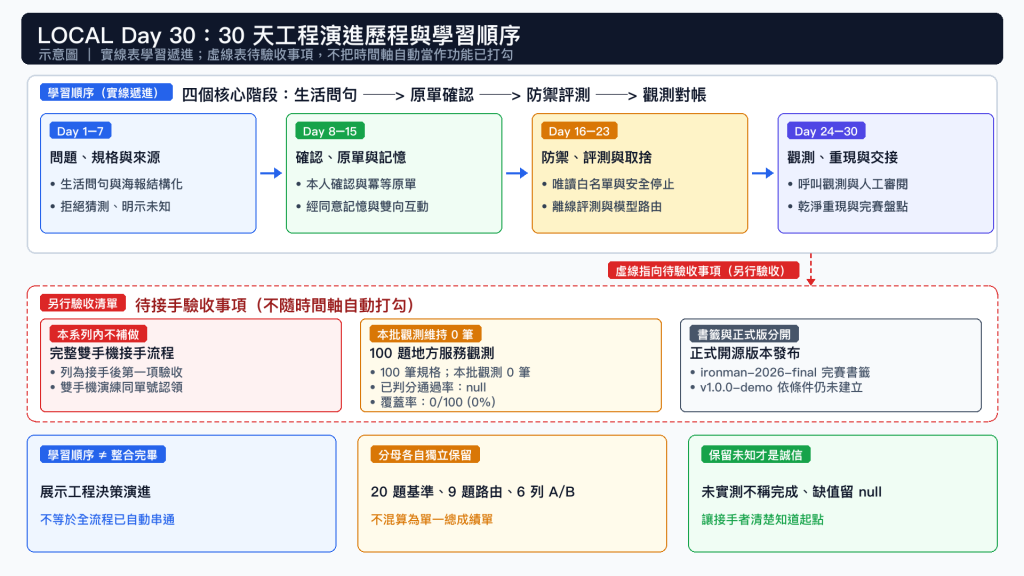
圖 1:30 天工程演進歷程與學習順序。箭頭表示學習順序;待驗收工作另列,不讓時間軸自動替功能打勾。
Day 27 實測已驗證手機端建立詢問與同單號查回,但那一次沒有走到店家查詢。Day 24 的實測裡,模型對超出範圍的問句要求過 show_local_help,但那是另一批紀錄,不能拿來解釋 Day 27 那一次。對帳結論是原因尚未知,接手時須比對當次問句與工具要求,不另猜測。[1][2]
回顧不能把不同天的漂亮數字湊成一張成績單。我將已刊成果和新規格分開:同一個比例旁邊,要看得見它測了誰、用了多少樣本。
| 度量 | 可核對的結果 | 正確讀法 |
|---|---|---|
| 工具選擇 | Day 24 路由 9/9,100% | 固定九題的工具要求符合契約 |
| 參數正確性 | 同九題的工具參數通過核對 | 不是所有 Schema 錯誤的攔截率 |
| 資料依據 | Day 25 有抽取與採用規則;未核實時段保留 null |
尚無跨全部回答的依據正確率 |
| 邊界拒絕 | Day 16 唯讀能力、後端授權與反例規格 | Day 29 反例子題 26 筆,服務結果未取得 |
| 任務完成 | Day 27 單手機保存查回、Day 19 本機認領有各自紀錄 | 42 項工具測試不代替 100 題服務完成率 |
| 延遲與成本 | Day 24 六列 A/B:2,602.4~4,666.9 ms | 同批歷史單次呼叫;不是全任務延遲 |
成本延續 Day 20 與 Day 24 的事後牌價重算表:六列每次約 0.0009968~0.0012578 USD ,含該表記錄的輸出與思考 Token。[2] 這是依 2026/10/08 保存牌價估算的模型費用,範圍不含 LINE、資料庫及整套服務維運。
下面重算同一份表,不發出新請求。Decimal 用十進位數值保留計價精度,ROUND_HALF_UP 明示最後一位的取捨;它是在檢查算式,不是重新證明呼叫曾發生。
from decimal import Decimal, ROUND_HALF_UP

# Day 24 公開重算表:題號、組別、輸入、輸出、思考 Token。
rows = [
    ("local11", "A", 767, 29, 114),
    ("local11", "B", 767, 29, 153),
    ("local12", "A", 769, 33, 79),
    ("local12", "B", 769, 33, 116),
    ("local19", "A", 781, 19, 101),
    ("local19", "B", 781, 19, 144),
]
input_rate = Decimal("0.75")  # 當時保存的 USD / 1M tokens
output_rate = Decimal("3.75")
unit = Decimal("1000000")
precision = Decimal("0.0000001")

for case_id, arm, prompt, output, thoughts in rows:
    counts = (prompt, output, thoughts)
    if any(type(n) is not int or n < 0 for n in counts):
        raise ValueError("INVALID_TOKEN_COUNT")
    amount = (
        Decimal(prompt) * input_rate
        + Decimal(output + thoughts) * output_rate
    ) / unit
    rounded = amount.quantize(precision, rounding=ROUND_HALF_UP)
    print(f"{case_id}/{arm}: {rounded} USD")
每題每設定僅一次觀察,三個配對差值只描述當次結果。六列計價齊備仍有 safe_to_deploy=false,僅檢驗呼叫與成本,未放行通知或接手。
回頭看,我最常問的不是「還能加哪個產品」,而是「這一步需要模型判斷嗎?」例如查回一張已保存的單,應由後端讀狀態,不用再請模型猜一次。
| 工具或服務 | LOCAL 裡的角色 | 我保留的取捨 |
|---|---|---|
| Google AI Studio | Day 3 提示與輸入原型 | 畫面試通之後,仍保存可重現設定 |
| Gemini Developer API | Day 6、Day 25 模型理解、工具要求與資料抽取 | 連網呼叫紀錄與確定性測試分開 |
| Google Gen AI SDK | Day 3、Day 24 明示呼叫設定與存取入口 | 換 client 需重新核對模型及參數 |
| Google ADK | Day 5、Day 8 安排工具與 Session 互動 | 編排能力不等於寫入授權;版本以相依清單為準 |
| Cloud Run | Day 12 承載容器與版本部署 | revision 存在、流量分配、當次請求分開查 |
| Cloud Logging/Trace | Day 21 結構化事件與請求關聯 | 已有日誌對應,未宣稱 Cloud Trace 匯出完成 |
| Cloud Firestore | Day 11、Day 12 保存原單與交易狀態 | 人工認領接線要另驗;交易回呼可能重試 |
| Vertex AI 存取路徑 | Day 23、Day 29 雲端憑證與模型設定的抽離設計 | 本系列驗過設定分流,尚未完成兩端推論比較 |
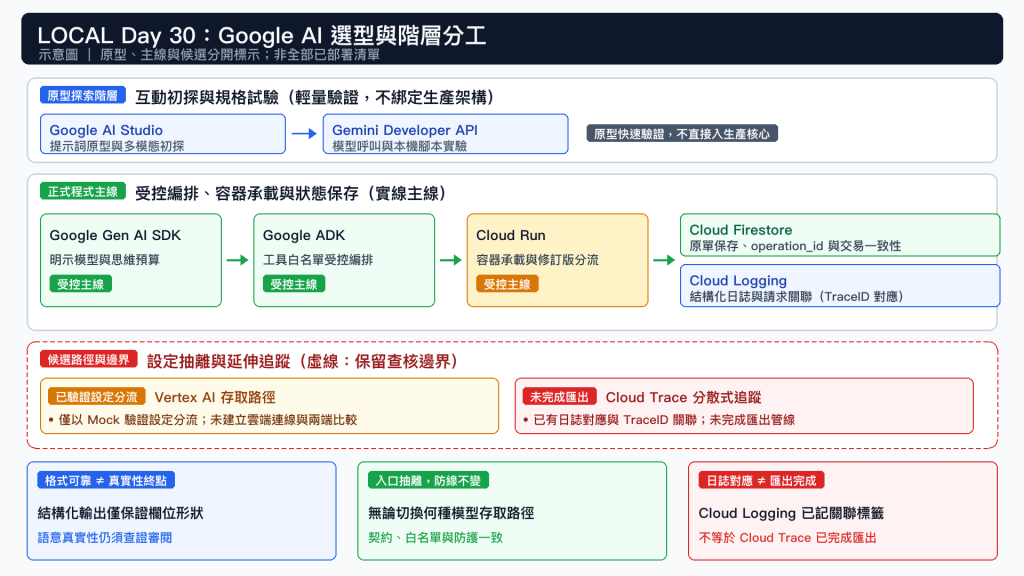
圖 2:Google AI 選型與階層分工。原型、程式與候選分開閱讀;圖中的服務名稱不是全部部署完成的清單。
拿掉模型,查回原單與版本核對仍可由程式完成;但地方散文轉成候選欄位,就得另寫抽取規則或由人整理。這是工作分工的比較,不是已量測的省時比例。Day 25 讓 Gemini 產生候選,再經規則檢查與人工採用;五筆模型案例留下三筆採用、兩筆阻擋,不能把 3/5 當成模型準確率。[1]
「不提供全素」包含「全素」兩字,正好暴露字面比對的限制。結構化輸出管資料形狀,Pydantic 管應用規則,ReviewReceipt 留下人工採用依據。[3] 我接受多一道審閱工序,換取來源與採用決定可以分開追查;不是讓人重做抽取,也不是讓模型自行核准。 格式可靠,是查核的起點,不是真實性的終點。
生產就緒是下一階段目標,不是本篇的完成宣告。新功能沿同意、來源、交易與交接規則增加,不因分成更多 Agent 就取得更多權限。
Sub-Agent 是分工的代理人。我規劃以協調者分派生活情報、公務草稿與志工建議;核准辦理仍由具有當前身分與權限的流程決定。[3] 接手後先完成原單的雙手機驗收,再評估專責角色;多一個角色名稱,不能跳過原本的完成條件。
| 規劃中的角色 | 可以提出的候選內容(延伸篇章) | 開放前須補齊的驗收條件 |
|---|---|---|
| 生活情報檢索 Agent | 友善活動、蔬食店家與無障礙來源候選(Day 5、Day 14) | 資料更新、來源失效與 Day 17 查無資料對照 |
| 公務受控辦理 Agent | 高齡補助表單草稿與應備資料說明(Day 8、Day 16) | 機關正式授權、核准流程及測試環境 |
| 志工派工協調 Agent | 依照護範圍及排班提出派工建議(Day 9、Day 19) | 雙手機真實認領競爭、通知與同單號查回 |
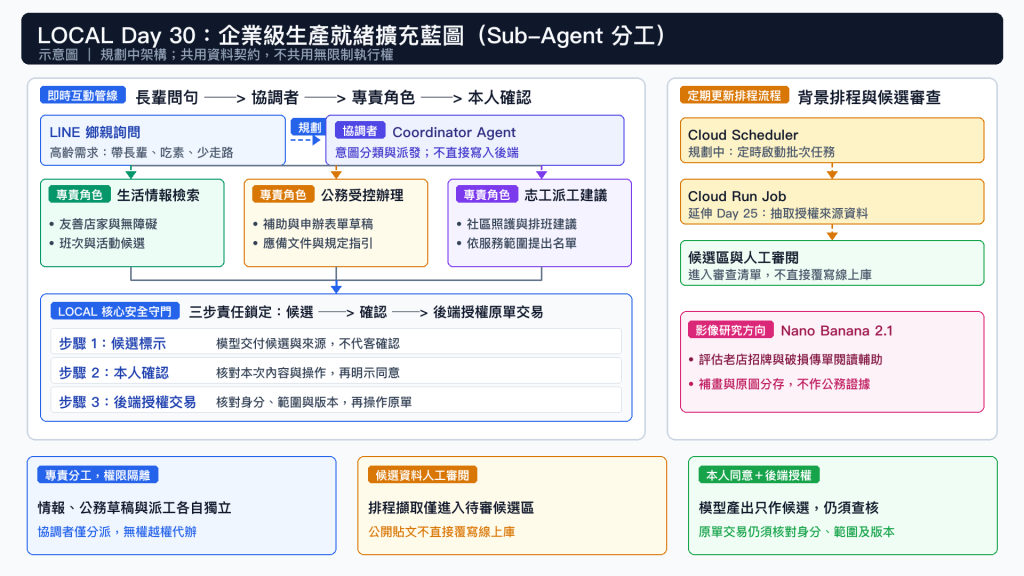
圖 3:未來擴充之 Sub-Agent 分工藍圖。協調者與專責角色都在規劃中;共用資料契約,不共用無限制的執行權。
資料更新可由 Cloud Scheduler 定時啟動 Cloud Run Job,延伸 Day 25 抽取採用流程。[4] 優先選取授權來源並保存版本,重跑僅產出可辨識候選。社群公開貼文不等於自動取得批次擷取權利。
Nano Banana 2.1 為影像研究方向。官方文件的生成與編輯能力有助評估文創及老店招牌素材,功能待實驗核對。[5] 破損傳單補畫可助閱讀但須與原圖分存,新增筆畫不得視為原公告證據。
這 30 天,有四件事改變了我對「完成」的判斷。
第一,逾時不等於失敗。從 Day 1 的 handoff-timeout-001 規格到 Day 2、Day 10 的合成故障注入,詢問可能已保存,回覆卻遺失。再送一次看似簡單,但若換成新操作,就可能多建一張單。我選擇先查原操作,查不明就留下待確認。代價是多一個狀態,也要交代查回、重試與畫面;省下的是讓下一個人猜這張單到底存了沒有。這是故障演練,不是現場事故或金流驗收。[1]
第二,按鈕反灰不是後端的防重送。使用者可以往上滑再點一次舊卡,平台也可能重送事件,所以 Day 9 與 Day 13 將事件的重複過濾與業務 operation_id 分開,原操作綁定原本的內容;志工認領時的 Firestore 版本核對,仍是待接線的契約。[1]
第三,提示詞不能代替權限。Day 16 與 Day 22 把外部文字一律當成資料,模型抽取的結果先進候選區;要建立詢問或修改狀態,仍要經過本人確認與後端授權,措辭被誘導也過不了這一關。
第四,函式測試通過,不等於服務載入正確。Day 28 用錯誤的 app 入口與漏掉的路徑前綴,在本機重現了 404 反例;線上那一次的根因,還是要核對入口、映像與修訂版。[1]
我把這些經驗收成三個問題:這個回答依據什麼?這次動作由誰核准?完成後留下什麼可查結果?它們不是新協定,而是我檢查下一個功能的方法。
Day 6 讀者追問圖片與場次版本,推動 Day 7 的來源更新與複核。[1] AI 協作也一樣:初稿、程式與審查可以分工,但我仍需看差異、核對原始結果。最容易被流暢文字偷換的,是「候選」與「完成」。
我沒有在結尾另加框架。通用 Agent 平台(如 OpenClaw)或 MCP 工具箱可以幫忙串接系統,但地方來源的時效、本人同意與原單規則不能外包;小規格、修改、反例與驗證,才是這 30 天的節奏。
四個目標共用同一批素材。交付包另附 30 章書稿企劃,列出學習目標、程式入口與故障練習;它是編輯提案,不是出版合約。
| 目標 | 現在能拿出的素材 | 下一個完成條件 |
|---|---|---|
| 鐵人賽作品 | 30 篇章節、原始紀錄、版本與反例 | 本篇完成發布;競賽結果依正式公告 |
| 技術專書 | 30 章學習路徑、程式、圖稿與練習題材 | 全書校訂、環境統一及出版合作 |
| Google Developer Experts | 繁中技術說明、英文入口、乾淨容器與開源交付 | 持續分享與實際社群貢獻;資格另循正式程序 |
| 年度技術大會分享 | AI 協作中的來源核對、誤讀與驗收案例 | 沿既定議程準備,現場回饋另留紀錄 |
大會分享取用的是 AI 協作與驗收經驗,不把既定議程改成 LOCAL 全功能成果發表。GDE 與出版同樣是下一段工作,不能由一份連載的頁數代替。[7]
讀者現在可先下載固定程式快照,對照雙語 README 產品卡,解壓後在含 eval/ 與 examples/ 的根目錄開終端機。除了 Day 27 已驗證的 Google Cloud Shell 乾淨容器路徑,本機只要有 Python 3.10+ 即可走 Day 29 標準函式庫路徑。
python3 -m unittest discover -s examples/day29 -p test_acceptance.py -v
python3 -O -m unittest discover -s examples/day29 -p test_acceptance.py -v
python3 examples/day29/acceptance.py --plan --out out/day30/plan-01
打開 out/day30/plan-01/report.json,應看到 planned=100、tested=0、pass_rate_observed=null。前兩行各測同組 42 項,不是服務通過率。再用原輸出目錄重跑第三行,應拒絕覆寫;新實驗換目錄。
程式採 MIT 授權,文字與照片授權另行確認。CONTRIBUTING.md 提供回報指引,請附環境、版本與去識別重現結果。[6]
我已建立並推送 ironman-2026-final,指向工程快照 0d939fd。它有三個交付用途:
main 後續修改不會自動移動標籤;重現仍須固定環境與資料。v1.0.0-demo 仍待雙手機與服務觀測等驗收。一般 Git tag 可以刪除或重新指向,並非不可變保證。我不移動已公開標籤;後續修訂另建版本。[6] GitHub Desktop 可建立帶註解標籤並推送;下列僅示範本機命令列建立形式,既有名稱不必重跑,也不是實際操作日誌:
REV=0d939fdf2bc12745eb4ae0308ef31366b89d4408
# 已有此標籤時不要重建,也不要加強制覆蓋參數。
git tag -a ironman-2026-final "$REV" -m "LOCAL series snapshot; integration status is documented"
Tag 固定的是工程來源,不包含未進版的文章或圖床內容;未來觀測另建批次,不改寫今天的未知。
「把複雜的事情變得簡單,把枯燥乏味變得有趣」,是我一直想做的事。這 30 天讓它多了一個要求:簡單的畫面背後,事情仍要交代清楚。
回到「帶長輩、吃素、少走路」,我希望家人看到有依據的資訊,不是更肯定的猜測。手機實測留下同單號保存與查回的畫面,是可以核對的起點;它還不是志工已經接手的終點。[1]
謝謝一路提問的讀者,也謝謝讓技術有生活場景的地方夥伴。接手的人不必照抄 LOCAL 全部工具,但可以帶走三個問題:依據在哪裡、誰能決定、完成後怎麼確認。換到別的地方、另一個服務,這些問題仍然值得先問。
我交出去的不只是會回答的程式,也是讓下一個人知道何時能相信、何時該查證、何時必須交給人的方法。
這篇連載走到終點,讓地方一年比一年更好的工作,還會繼續。
[1] LOCAL:系列入口、固定工程來源 0d939fd、完賽標籤 ironman-2026-final、Day 29 受測版本 013b9f0、專用 CI Run 38334828824。
[2] Day 24:路由與原始量測核對表、2026/10/08 牌價重算表。
[3] Google:Gemini 結構化輸出、Gen AI SDK、ADK 協同工作流;Firestore:交易。
[4] Google Cloud:以 Cloud Scheduler 定時執行 Cloud Run Jobs。
[5] Google AI for Developers:Nano Banana 影像生成與編輯文件。
[6] 開源交付:MIT 原文、Git tag、GitHub Desktop 標籤、LOCAL 貢獻指南。
[7] Google:Google Developer Experts。
[8] 內政部戶政司:民國 114 年 12 月戶口統計資料分析。


 iThome鐵人賽
 看影片追技術